Kubernetes 1.37 verbessert die gemeinsame Planung von KI-Workloads. Doch acht verfügbare GPUs sind noch lange keine acht effizient nutzbaren GPUs. Entscheidend sind Topologie, Fabric und Datenpfade.
Für verteiltes Training zählt nicht nur die Zahl der GPUs. Entscheidend ist auch, wie sie über NVLink, PCIe und das Netzwerk miteinander verbunden sind.
Für viele Organisationen besteht die Herausforderung darin, den Orchestrierer zu einer wirtschaftlich tragfähigen und betriebssicheren Plattform für KI-Workloads im eigenen Rechenzentrum zu konfigurieren – eine Aufgabe, die deutlich komplexer ist als die reine Bereitstellung eines Kubernetes-Clusters. Die CNCF bezeichnet Kubernetes als das faktische „Betriebssystem“ für KI.
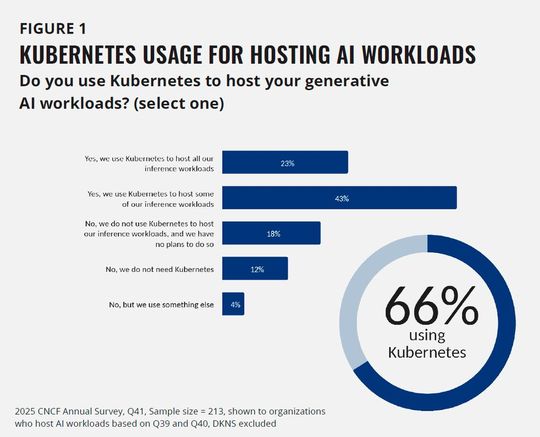
Kubernetes wird von 66 Prozent der Organisationen, die generative KI-Workloads hosten, für einige oder alle Inferenz-Workloads eingesetzt. Basis: 213 Organisationen; CNCF Annual Survey 2025.
(Bild: CNCF)
KI-Workloads verändern das Scheduling
Bei klassischen Cloud-nativen Anwendungen genügt es oft, CPU, Arbeitsspeicher und verfügbare Knoten zu verwalten. Für verteilte KI-Workloads muss der Scheduler zusätzlich berücksichtigen, welche Beschleuniger wo installiert sind, wie sie über PCIe, NVLink oder das Netzwerk miteinander verbunden sind und ob ihre Platzierung die knappen Ressourcen im Rack und in der Fabric effizient nutzt.
Das Emblem von Kubernetes v1.37 („Garhwal“). Die Version erweitert Kubernetes um Funktionen für workload-bewusstes Scheduling, die insbesondere verteilte KI- und ML-Workloads adressieren.
(Bild: k8s.io)
Genau an dieser Schnittstelle zwischen Orchestrierung und physischer Infrastruktur setzt Kubernetes 1.37 an, verfügbar seit dem 26. August 2026. Die Funktionen dieser Version sind im Kern eine Reaktion darauf, dass KI-Workloads im Rechenzentrum nicht mehr als unabhängig platzierbare Einzel-Pods behandelt werden können.
Für große KI-Trainingsjobs genügt es nicht, irgendwo genügend CPUs, Speicher und GPUs zu finden. Maßgeblich ist vielmehr, ob Beschleuniger, Nodes und Netzwerkpfade als funktionsfähige Einheit verfügbar sind. Kubernetes 1.37 ergänzt die Pod-zentrierte Planung um Workload-bewusstes Scheduling, PodGroup-Queueing und workload-bewusste Preemption. Die konkrete Topologie muss jedoch über eigene Regeln und Komponenten einfließen. Die Alpha-API CompositePodGroup kann hierarchische Gruppen für komplexe Workloads abbilden.
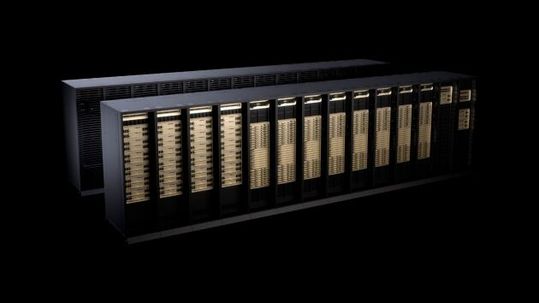
„Nvidia DGX Vera Rubin NVL72“: Ein Rack vereint 72 GPUs zu einer eng gekoppelten KI-Infrastruktur. Kubernetes muss solche Hardware- und Fabric-Domänen kennen, damit verteilte Trainingsjobs nicht über ungünstige Pfade fragmentiert werden.
(Bild: Nvidia)
Verteilte Trainingsjobs lassen sich mit Gang Scheduling als Pod-Gruppen behandeln. Der Scheduler prüft ihre Platzierungen in einem gemeinsamen PodGroup-Zyklus und bindet Pods erst, wenn mindestens die über minCount geforderte Zahl platziert werden kann. Eine räumlich oder netzwerktopologisch dichte Platzierung garantiert Gang Scheduling allein jedoch nicht.
Gang Scheduling und Workload-aware Preemption erreichen in Kubernetes 1.37 zwar den Beta-Status, sind jedoch standardmäßig noch deaktiviert. Beide hängen vom Feature Gate GenericWorkload sowie den Workload- und PodGroup-APIs ab. Das gemeinsame Framework zur Anbindung von Workload-Controllern und das neue Feld spec.scheduling für batch/v1-Jobs befinden sich noch im Alpha-Stadium. Auch entsteht damit kein umfassendes GPU-, Netzwerk- und Topologie-Scheduling.
Werden Pods später gelöscht oder verdrängt, kann eine laufende Gruppe zudem unter minCount fallen: Gang Scheduling garantiert die Mindestgröße bei der Erstplatzierung, nicht während der gesamten Laufzeit.
Preemption schafft nicht automatisch wirtschaftlich nutzbare Kapazität. Wird ein mehrstündiger Trainingslauf ohne aktuellen Checkpoint verdrängt, kann der verlorene Rechenaufwand größer sein als der Nutzen der freigeräumten GPUs.
Der Scheduler kennt Checkpoint-Alter, Wiederanlaufzeit oder Elastizität eines Trainingsjobs nicht als native Prioritätssignale; Plattformteams müssen solche Kriterien über Workload-Klassen, PriorityClasses, PodGroup-Disruption-Modi oder externe Steuerungslogik abbilden. Hinzu kommt, dass der kube-scheduler derzeit keine Preemption für über DRA belegte Geräte unterstützt.
Kubernetes adressiert somit zentrale Lücken beim Gang Scheduling und bei der Zuweisung spezieller Geräte. Für eine wirtschaftlich tragfähige Platzierung verteilter GPU-Workloads stehen dem Kernsystem vollständige Topologie-, Fabric-, Daten- und Laufzeitinformationen jedoch (bisher noch) nicht automatisch zur Verfügung.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Die Kern-APIs der Dynamic Resource Allocation sind seit Kubernetes 1.34 allgemein verfügbar und seit Version 1.35 nicht mehr abschaltbar. DRA standardisiert, wie Pods GPUs, NICs und andere Spezialgeräte anhand ihrer Eigenschaften anfordern und zugewiesen bekommen. Warteschlangen, Workload-Zulassung und Pod-Platzierung bleiben davon getrennte Aufgaben. Welche Eigenschaften bei der Auswahl berücksichtigt werden können, hängt von den Ressourcen und Attributen ab, die der jeweilige Gerätetreiber veröffentlicht; DRA allein macht ein Cluster nicht automatisch netzwerk- oder fabric-bewusst.
Topologiebewusst heißt noch nicht fabric-bewusst: Ein Rack-Label sagt, wo ein Node steht, aber nicht, wie viel Bandbreite auf seinem Uplink gerade verfügbar ist. Das native Topology-Aware Workload Scheduling bleibt vorerst Alpha und ist standardmäßig deaktiviert.
Inferenz braucht eine zweite Planungsebene
Bei der Inferenz löst Kubernetes zunächst nur die grobe Platzierungsaufgabe: Der kube-scheduler entscheidet, auf welchen Knoten die Pods eines Modellservers starten und welche Ressourcen sie erhalten. Sobald diese Replikate laufen, beginnt jedoch eine zweite, wesentlich schnellere Planungsaufgabe: Jede einzelne Anfrage muss an genau den Endpunkt gelangen, der sie mit möglichst geringer Latenz und ohne unnötige GPU-Arbeit bearbeiten kann. Diese Entscheidung kann nicht allein auf Pod-Ressourcen, Node-Labels oder statischen Service-Endpunkten beruhen. Hier setzt die Gateway API Inference Extension an.
Training und Inferenz benötigen daher unterschiedliche Scheduling-Ebenen:
Beim Training müssen Worker als Gruppe zugelassen und topologisch sinnvoll platziert werden.
Bei der Inferenz entscheidet Kubernetes zunächst über die Platzierung der Model-Server. Anschließend muss aber ein zweiter Mechanismus jede Anfrage an die passende Replik weiterleiten.
Dieses Request-Routing berücksichtigt idealerweise Queue-Tiefe, Modell- und LoRA-Verfügbarkeit, Prefix- beziehungsweise KV-Cache und aktuelle Last. Der kube-scheduler sieht diese Informationen nicht.
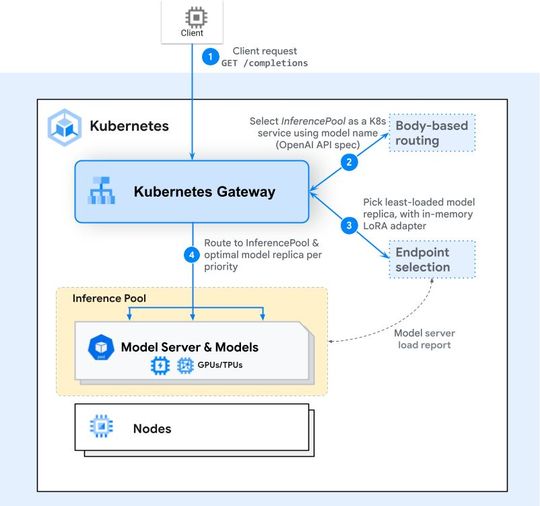
Die Gateway API Inference Extension trennt das Inference Gateway als Eintrittspunkt für Anfragen vom Inference Router beziehungsweise Endpoint Picker, der für die Auswahl einer konkreten Modellreplik zuständig ist. Der Router kann zur Laufzeit beispielsweise berücksichtigen, ob das angefragte Modell auf einer Replik bereits geladen ist, ob ein benötigter LoRA-Adapter verfügbar ist, wie hoch deren aktuelle Auslastung und Queue-Tiefe sind und ob ein passender Prefix- oder KV-Cache vorhanden ist.
Wird eine Anfrage an einen Endpunkt geleitet, der Modellgewichte oder Adapter erst laden muss oder keinen nutzbaren Cache besitzt, steigen Latenz, Speicherverkehr und GPU-Kosten. Ein modellbewusstes Routing bevorzugt dagegen nach Möglichkeit Replikate mit warmem Modellzustand und passenden Cache-Einträgen. Kubernetes bleibt damit für die Platzierung und Skalierung der Serving-Pods zuständig; der Inference Router übernimmt die anfragegenaue, laufzeitbasierte Auswahl innerhalb dieses bereitgestellten Pools.
Welche Laufzeitsignale tatsächlich in die Auswahl einfließen, hängt vom eingesetzten Gateway, Endpoint Picker und Modellserver ab. Der vom Projekt bereitgestellte Lightweight Endpoint Picker dient vor allem Konformitätstests; für Produktivumgebungen sind eigene Implementierungen oder bestehende Lösungen wie der llm-d-router vorgesehen.
Die Gateway API Inference Extension trennt den Zugangspunkt für Anfragen vom modellbewussten Routing: Ein Endpoint Picker kann Modellreplikate anhand von Faktoren wie Auslastung, geladenem LoRA-Adapter und Cache-Status auswählen.
(Bild: k8s.io)
GPU-Cluster brauchen Topologiebewusstsein
Der Standard-Scheduler bewertet Pods traditionell anhand deklarierter Ressourcen und Platzierungsregeln. Die gemeinsame Laufzeit eines kollektiv kommunizierenden GPU-Jobs war dabei lange keine eigenständige Planungseinheit.
Doch GPU-Cluster für KI/ML-Arbeitslasten folgen einer anderen ökonomischen und technischen Logik als Microservices oder andere containerisierte Anwendungen. Bei verteiltem Training zählt nicht nur die Zahl der verfügbaren GPUs, sondern auch etwa deren Lage im Rack, ihre Anbindung über PCIe oder NVLink, die Nähe zu NICs und die Qualität der RDMA-Fabric: Diese Größen entscheiden mit darüber, ob das Cluster effizient trainiert oder durch die Synchronisation ausgebremst wird.
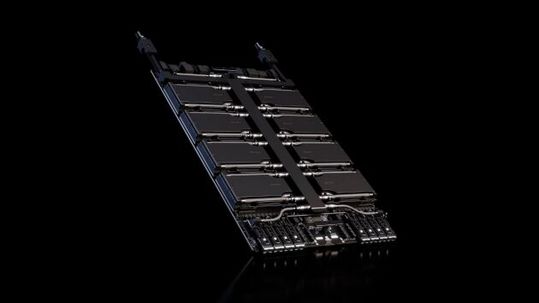
„Nvidia HGX Rubin NVL8“: Die acht GPUs sind über NVLink der sechsten Generation verbunden. Für synchrones Training zählt deshalb nicht nur die GPU-Zahl, sondern auch ihre Lage innerhalb von NVLink-, PCIe- und Netzwerkdomänen.
(Bild: Nvidia)
Ein mehrknotiger Trainingsjob darf nicht scheitern, weil nur ein Teil seiner Worker gestartet wird. Ebenso wenig sollte ein Job über weit entfernte oder unterschiedlich angebundene Knoten verteilt werden, wenn seine Trainingsbibliothek intensiv All-Reduce-, All-Gather- oder All-to-All-Kommunikation nutzt. Bei solchen kollektiven Operationen kann der langsamste Pfad alles ausbremsen.
Kubernetes kann Ressourcen sichtbar und adressierbar machen; es kennt aber nicht automatisch die Performance-Eigenschaften jeder GPU-Gruppe, jedes NVLink-Verbunds und jeder Netzwerkstrecke. Diese Semantik müssen Infrastruktur- und Plattformteams über Labels, Policies, Scheduler-Erweiterungen und verlässliche Telemetrie ergänzen.
Praktische Herausforderungen beim GPU-bewussten Scheduling
Selbst mit den neuen Funktionen von Kubernetes 1.37 reicht der kube-scheduler allein nicht für alle Anforderungen verteilter Trainingsläufe und gemeinsam genutzter GPU-Cluster aus. In einem geteilten GPU-Cluster lautet die eigentliche Frage: „Welche zusammenhängende GPU-Gruppe lässt diesen konkreten Job wirtschaftlich und mit dem erwarteten Kommunikationsprofil laufen?“
Ein Trainingslauf auf acht GPUs innerhalb derselben NVLink-/NVSwitch-Domäne kann deutlich schneller sein als derselbe Lauf auf acht GPUs, die über mehrere Hosts und Netzwerk-Switches verteilt sind. Die Rechenleistung liegt zwar nominell bereit, doch Synchronisation, Datenbewegung und Netzwerkkonflikte können die effektive Auslastung drastisch senken.
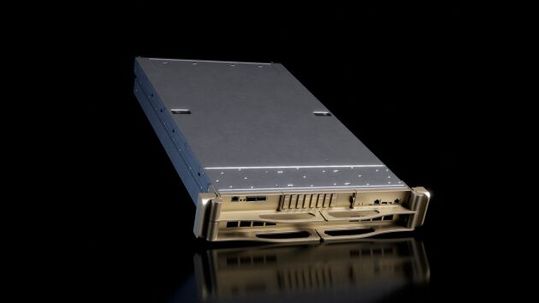
„Nvidia DGX Rubin NVL8“: Acht GPUs in einem flüssigkeitsgekühlten System reduzieren die physische Distanz zwischen Beschleunigern. Für Kubernetes bleibt entscheidend, ob eine vollständige, topologisch passende GPU-Gruppe gleichzeitig verfügbar ist.
(Bild: Nvidia)
Für große Trainingslasten muss die Topologie der Hardware Teil der Scheduling-Entscheidung werden.
Google dokumentiert diesen Ansatz für Google Kubernetes Engine (GKE) als Topology Aware Scheduling (TAS) in Kueue. Kueue berücksichtigt die physische Topologie und verfügbare Kapazität bei der Workload-Zulassung; die konkrete Node-Zuweisung übernimmt anschließend der kube-scheduler.
Dafür nutzt GKE die Topologie-Labels cloud.google.com/gce-topology-block, cloud.google.com/gce-topology-subblock, cloud.google.com/gce-topology-host und kubernetes.io/hostname.
Nach Angaben von Google kann eine ungünstige Platzierung die Gradientenaggregation verlangsamen. Bei ranggeordneten Kollektivverfahren wie Ring-All-Reduce können zusätzliche Netzwerk-Hops zwischen aufeinanderfolgenden Workern die Contention erhöhen und die nutzbare Bandbreite verringern. Ziel ist deshalb eine möglichst dichte Platzierung entlang der Netzwerktopologie, um Konvergenzzeit und Trainingsdauer zu verkürzen.
Für Plattformbetreiber ergeben sich daraus sechs Planungsregeln:
• GPU-Pools nach Hardware- und Netzwerkeigenschaften trennen, etwa nach GPU-Generation, Speichergröße, NVLink-Domäne, RDMA-Fähigkeit und Standort;
• Synchrone, nicht-elastische Trainingsjobs erst zulassen, wenn die vollständige Gruppe bereitsteht; bei elastischen Jobs muss mindestens die technisch und wirtschaftlich sinnvolle Mindestgröße als minCount definiert sein;
Quoten und Prioritäten nicht nur pro Namespace, sondern nach Teams, Mandanten, Workload-Klasse und Geschäftskritikalität definieren;
Inferenz und Training logisch oder physisch entkoppeln, damit Latenzanforderungen der Produktion nicht mit langen Trainingsläufen kollidieren;
Beschleuniger-, Netzwerk- und Job-Telemetrie zusammenführen: GPU-Auslastung allein zeigt nicht, ob ein Trainingsjob auf Daten, I/O oder eine bestimmte GPU-Topologie wartet.
Topologische Nähe nur dort zwingend vorgeben, wo der Leistungsvorteil den Verlust an Fehler-, Strom- und Wartungsdomänen überwiegt; andernfalls sollte sie als Präferenz behandelt werden;
Zuweisungsmodell je Workload-Klasse festlegen: Exklusive Voll-GPUs für eng gekoppelte, bandbreiten- und latenzsensitive Trainingsläufe; MIG für klar dimensionierbare, isolierungsbedürftige kleinere Workloads; Time Slicing nur dort, wo variable Leistung, fehlende Speicherisolation und gegenseitige Beeinflussung akzeptabel sind.
Ob eine Platzierung wirtschaftlich arbeitet, zeigen erst gemeinsame Betriebskennzahlen: GPU-Leerlaufzeit, Queue-Wartezeit, Job Completion Time und Netzwerkstall beim Training sowie Time to First Token und Durchsatz bei der Inferenz. Für Rechenzentrumsbetreiber kommt noch der Energiebedarf hinzu.
Der Datenpfad wird zum Engpass
Containerisierung abstrahiert Software-Abhängigkeiten, sie hebt jedoch keine physikalischen Grenzen auf. Bei hochparallelem Training bestimmen Strom, Kühlung, Speicher, PCIe-/NUMA-Layout, GPU-Interconnect und Netzwerk-Fabric den erreichbaren Durchsatz mit.
Besonders kritisch sind vier Engpassklassen:
Fragmentierung: Einzelne freie GPUs können über Nodes, Racks oder Hardwaregenerationen verstreut sein. Für einen synchronen Distributed-Training-Job sind sie dann unter Umständen nicht sinnvoll kombinierbar.
Topologieabhängigkeit: GPU-zu-GPU-Kommunikation profitiert von kurzen, schnellen Pfaden. Ein Scheduler muss deshalb Kenntnis über Host-, Rack-, Zone- und Fabric-Strukturen erhalten – und diese Informationen aktuell halten.
Datenlokalität: Große Trainingsdatensätze, Checkpoints und Modellartefakte müssen mit ausreichendem Durchsatz zum Job gelangen; andernfalls entsteht GPU-Starvation: Teure Beschleuniger warten auf Daten, statt Rechenoperationen auszuführen.
Netzwerk: Verteilte Frameworks nutzen kollektive Kommunikationsmuster. Jitter, Paketverluste, Überbuchung oder asymmetrische Pfade können die Skalierung verschlechtern; bei RoCE-Umgebungen (RDMA-over-Converged-Ethernet) werden QoS-, PFC- und ECN-Konfigurationen deshalb zu betriebsrelevanten Einflussgrößen.
Kubernetes ersetzt die Fabric nicht; der Orchestrierer kann fehlende Bandbreite, unpassende NUMA-Topologie oder eine überbuchte Leaf-Spine-Topologie nicht kompensieren. Scheduling benötigt verlässliche Topologie- und Kapazitätsdaten; kurzfristige Lastsignale sollten zusätzlich Workload-Zulassung, Autoscaling und Inferenz-Routing steuern.
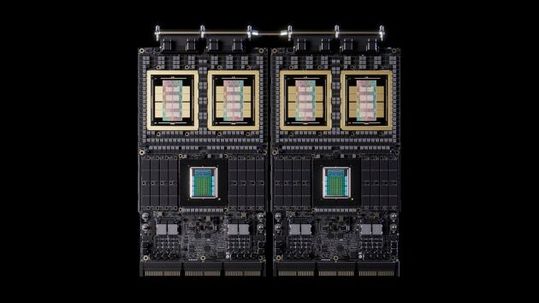
„Nvidia Vera Rubin NVL4“: Vier GPUs und zwei CPUs bilden eine kompakte Recheneinheit. Kubernetes kann Ressourcen zuweisen, muss für effiziente KI-Workloads jedoch auch NUMA-, Daten- und Netzwerkpfade berücksichtigen.
(Bild: Nvidia)
Statische beziehungsweise langsam veränderliche Informationen wie GPU-Modell, NUMA-Zuordnung, Rack, Fabric-Domäne oder Gerätezustand eignen sich für Scheduling-Entscheidungen. Schnell schwankende Werte wie aktuelle Netzwerkbelastung, GPU-Auslastung oder Storage-Durchsatz gehören eher in Admission Control, Autoscaling, Request-Routing, Alerting und gegebenenfalls Descheduling. Werden sie ungefiltert in die Platzierung eingespeist, drohen instabile Entscheidungen auf Grundlage bereits veralteter Messwerte.
Rack-Leistungsgrenzen und thermische Zonen sind keine nativen Kubernetes-Ressourcen. Betreiber müssen sie über getrennte Pools, Labels, Quoten, Taints oder Admission Policies abbilden. Schnell wechselnde Temperatur- und Leistungswerte eignen sich eher für Alerting, Autoscaling und kontrolliertes Descheduling als für das unmittelbare Scheduler-Scoring.
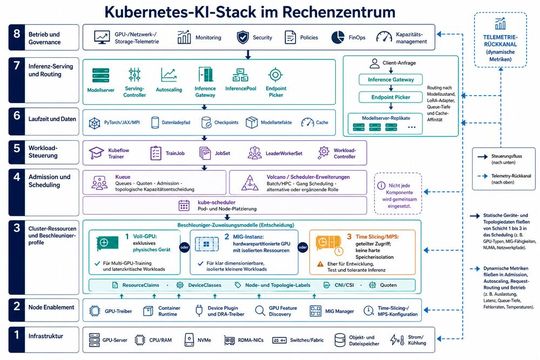
Die Planung von KI-Workloads ist keine Aufgabe eines einzelnen Schedulers. Sie entsteht im Zusammenspiel mehrerer Ebenen, APIs und Controller, deren Zuständigkeiten sich teilweise überschneiden:
Infrastruktur: GPU-Server, CPU, RAM, NVMe, GPU-Interconnects, RDMA-NICs, Switches, Storage sowie Strom- und Kühlinfrastruktur.
Node-Bereitstellung und -Enablement: Node-Provisioner, Autoscaler, GPU-Operatoren, GPU-Treiber, Container Runtime, Device Plugins, GPU Feature Discovery, MIG-Verwaltung bei NVIDIA-GPUs, DRA-Treiber und RDMA-Komponenten.
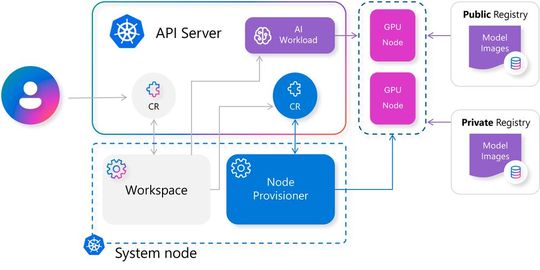
KAITO verbindet KI-Workloads in Kubernetes mit einem Workspace und Node Provisioner: Custom Resources beschreiben die gewünschte Modellbereitstellung; der Provisioner stellt GPU-Knoten bereit und lädt Modell-Images aus öffentlichen oder privaten Registries.
(Bild: KAITO Project/CNCF)
Cluster-Ressourcen: Kubernetes-APIs, CNI, CSI, Node-Labels, Topologieinformationen, ResourceClaims, DeviceClasses und Quoten.
Zulassung und Planung: Kueue steuert Warteschlangen, Quoten, Prioritäten und die Workload-Zulassung; die Node-Platzierung übernimmt anschließend in der Regel der kube-scheduler. Volcano kombiniert Batch- und Gang-Scheduling mit einem eigenen Scheduler.
Workload-Steuerung: Kubeflow Trainer, JobSet, LeaderWorkerSet und weitere Controller beschreiben und steuern den Lebenszyklus verteilter Trainings- und Inferenzworkloads.
Laufzeit und Daten: Trainingsframeworks wie PyTorch und JAX, Kommunikationsschichten wie MPI, NCCL und UCX sowie Datensätze, Checkpoints, Modellartefakte, Registries, Objekt- und Artefaktspeicher und Daten-Caches.
Inferenz: Modellserver, Serving-Controller, Autoscaling, Inference Gateway, InferencePool und Endpoint Picker übernehmen die Bereitstellung, Skalierung und anfragebezogene Auswahl der Modellreplikate.
Betrieb: GPU-, Netzwerk-, Storage- und Job-Telemetrie, DCIM- und BMS-Daten zu Leistung und Temperatur, Kapazitäts- und Kostensteuerung, Security, Policy Enforcement und Incident Management.
Die Qualität des Schedulings hängt nicht allein vom Scheduler ab, sondern vom Zusammenspiel aller Ebenen und der Qualität der zugehörigen Infrastruktur- und Zustandsdaten.
Der Kubernetes-KI-Stack im Rechenzentrum: Topologie und Geräteeigenschaften beeinflussen die Platzierungsentscheidungen; Telemetrie liefert Rückkopplung für Routing, Autoscaling und Betrieb.
(Bild: Autoren)
Fazit
Kubernetes entwickelt sich vom Vermittler einzelner Container zum Scheduler ganzer KI-Workloads – und muss dabei zunehmend die Grenzen und Topologie des Rechenzentrums mitdenken.
Kubernetes 1.37 schließt zwei Lücken, die beim Betrieb verteilter KI-Workloads besonders teuer werden können. Gang Scheduling behandelt die Pods eines Trainingsjobs im Upstream-kube-scheduler als zusammengehörige Gruppe; Workload-aware Preemption berücksichtigt bei Verdrängungsentscheidungen PodGroups statt nur einzelner Pods. Damit kann der Scheduler verhindern, dass ein Teil eines Trainingsjobs bereits GPUs belegt, obwohl die übrigen Pods nicht starten können. Genau solche unvollständigen Zuweisungen lassen teure Beschleuniger arbeiten, warten oder ungenutzt blockiert.
Aus der gemeinsamen Zulassung mehrerer Pods wird jedoch noch lange keine optimale Ausführung.
Acht zugewiesene GPUs sind nicht automatisch acht gleichwertig nutzbare GPUs. Ihre Position innerhalb von NVLink-, NVSwitch-, PCIe- und Leaf-Spine-Topologien beeinflusst ebenso die Laufzeit wie der Weg zu Trainingsdaten und Checkpoints. DRA kann Geräte und deren Eigenschaften präziser beschreiben, doch die wirtschaftlich günstigste Platzierung entsteht erst, wenn Scheduler, Warteschlangensteuerung, DRA-Treiber, Infrastrukturtelemetrie und topologiebewusste Controller dieselbe physische Infrastruktur abbilden. Die Qualität des Schedulings hängt damit unmittelbar von der Qualität der bereitgestellten Topologie- und Zustandsdaten ab.
Bei der Inferenz stößt Kubernetes an eine weitere Grenze. Der kube-scheduler kann einen Modellserver auf einer geeigneten GPU platzieren, entscheidet aber nicht für jede einzelne Anfrage, welche Replik gerade das benötigte Modell geladen hat, über einen wiederverwendbaren Prefix-Cache verfügt oder die kürzeste Warteschlange bietet. Diese Aufgabe liegt auf einer anderen Zeitskala und wandert deshalb in modellbewusste Routing-Schichten wie die Gateway API Inference Extension.
Es entsteht folglich kein einzelner, allwissender KI-Scheduler, sondern ein mehrschichtiges Planungssystem: Der kube-scheduler übernimmt die Platzierung, Workload-Controller steuern den Lebenszyklus, und spezialisierte Komponenten ergänzen Warteschlangen, Zulassung, Fabric-Topologie, Gerätezuweisung und Request-Routing.
Version 1.37 macht Kubernetes zu einer leistungsfähigeren Steuerungsebene für KI-Infrastrukturen. Auch im Zusammenspiel mit den ergänzenden Komponenten lässt sich jedoch nicht garantieren, dass verteilte GPUs wie ein zusammenhängender Beschleuniger arbeiten. Effizientes KI-Scheduling beginnt genau dort, wo die reine Ressourcenzuweisung endet.