Jahrzehntelang galt der Fat-Tree als Standard für Rechenzentrumsnetzwerke. AWS setzt nun auf eine deutlich flachere Architektur, die mit weniger Routern auskommt und mehr Durchsatz bieten soll.
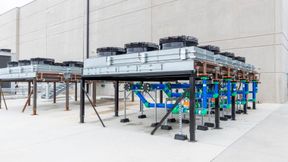
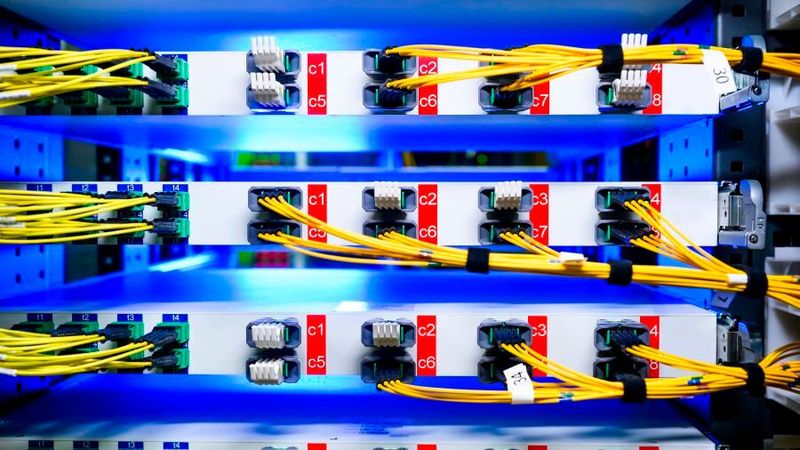
Close-up eines RNG-Racks: AWS ersetzt die klassische Fat-Tree-Architektur zunehmend durch Resilient Network Graphs. Was dahinter steckt.
(Bild: AWS)
Rechenzentren wachsen schneller als je zuvor, doch die zugrunde liegende Netzwerkarchitektur hat sich seit Jahrzehnten kaum verändert. Auslöser für die Entwicklung einer neuen Lösung war 2023 ein Hinweis auf Slack. Netzwerkexperte Ratul Mahajan (AWS) suchte jemanden mit Kenntnissen in Graphentheorie. Ihm antwortete Mathematikprofessor Seshadhri Comandur. Daraus entstand ein Projekt, das die Netzwerkarchitektur von Rechenzentren grundlegend verändert: Resilient Network Graphs (RNG).
Rechenzentren übertragen täglich enorme Datenmengen zwischen zahlreichen Servern. Standardarchitektur dafür ist der sogenannte Fat-Tree, der einem Organigramm ähnelt. Router sind dabei in hierarchischen Ebenen angeordnet, jeder Router verfügt über eine feste Anzahl an Ports, von denen ein Teil für Serververbindungen reserviert ist. Datenpakete müssen die Hierarchie aufsteigen bis sie den Zielrouter erreichen, und werden danach wieder nach unten geleitet.
Die Grenzen der klassischen Fat-Tree-Architektur
Diese Struktur lässt sich einfach umsetzen, hat aber handfeste Nachteile. Zusätzliche Router-Ebenen erzeugen beispielsweise Overhead. Viele Verbindungen laufen über wenige zentrale Knoten, daher kann der Ausfall eines einzelnen Routers ganze Netzbereiche lahmlegen. Dass eine flache Architektur die bessere Alternative ist, ist in der Forschung seit den frühen 1990er Jahren bekannt.
Verbinden sich Router direkt und nach dem Zufallsprinzip miteinander, entstehen deutlich mehr unabhängige Pfade zwischen allen Routerpaaren. Fällt in einem solchen Netzwerk ein Prozent der Router aus, geht auch nur etwa ein Prozent der Kapazität verloren. Der Verlust bleibt proportional, statt sich an einzelnen Punkten zu konzentrieren.
Die Umsetzung im echten Rechenzentrum scheiterte trotzdem. Zufällig verkabelte Router erzeugen ein unüberschaubares Kabelchaos, und die Berechnung optimaler Pfade durch ein zufälliges Netzwerk überfordert handelsübliche Router bei weitem.
Nach Angaben der beteiligten Wissenschaftler benötigen Standardansätze für Multipath-Routing in flachen Topologien 20- bis 80-mal mehr Arbeitsspeicher, als in gängiger Hardware verbaut ist. Hinzu kommt ein drittes Problem, denn ohne verlässliche mathematische Modelle lässt sich vorab nicht belegen, ob ein solches Netzwerk die geforderte Kapazität überhaupt erreicht. Die Idee blieb deshalb über Jahrzehnte reine Theorie.
Von der Theorie zur produktiven Architektur
AWS hat diese drei Probleme mit einem Ansatz gelöst, den das Team Resilient Network Graphs nennt. Kern ist eine quasi-zufällige Topologie. Die Idee ist ein kalkulierter Kompromiss, der weder vollständig zufällig noch hierarchisch ist, aber die mathematischen Vorteile zufälliger Netzwerke liefert und trotzdem in der Praxis handhabbar bleibt. Zwei Neuentwicklungen machen das möglich: die „ShuffleBox“ und das Routing-Protokoll Spraypoint.
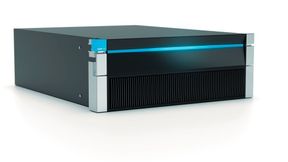
Die ShuffleBox ist ein rein optisches Element ohne eigenen Stromanschluss. Zwischen den Servern und den Leitungen zu anderen ShuffleBoxen platziert, verbindet sie die Kabel intern nach einem festen Muster, das die Wissenschaftler zuvor mathematisch berechnet haben.
Genau dieses Muster macht den Unterschied. Erst durch das feste interne Schema ergeben die Verbindungen zwischen vielen ShuffleBoxen jene quasi-zufällige Topologie. Wie dieses Muster aussehen musste, war lange unklar, bis Comandur eine entscheidende Gleichung lieferte.
Es sollten per Simulation acht Zahlen ermittelt werden, die diese Gleichung erfüllen. Aus den gefundenen Werten entstand die Bauanleitung, nach der heute jede ShuffleBox weltweit gefertigt wird.
Für das Routing-Problem hat das Team das Protokoll Spraypoint entwickelt. Der Quellrouter schickt hierbei den Datenverkehr zunächst zufällig an alle benachbarten Router. Anschließend übernimmt ein klassischer Shortest-Path-Algorithmus die Pakete und leitet sie zu festgelegten Waypoint-Routern weiter.
Diese Waypoint-Router bilden um jeden Zielrouter einen inneren und einen äußeren Ring, und der Verkehr bewegt sich von Ring zu Ring, bis er sein Ziel erreicht. So entstehen fast doppelt so viele unabhängige Pfade wie beim klassischen Shortest-Path-Routing. Das verringert Staus im Netzwerk und sorgt dafür, dass der Ausfall einzelner Router deutlich weniger ins Gewicht fällt.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Mehr zum Thema: ShuffleBox und Spraypoint im Überblick
ShuffleBox
Passives optisches Bauteil ohne eigene Stromversorgung;
Feste, mathematisch berechnete interne Verkabelung erzeugt eine quasi-zufällige Topologie;
Neue Racks werden einfach in freie Ports gesteckt, eine Neuverkabelung entfällt.
Spraypoint
Zweistufiges Routing-Protokoll: Zufällige Auswahl von Nachbarroutern, danach gezielte Weiterleitung über Waypoint-Router;
Arbeitet mit inneren und äußeren Ringen um jeden Zielrouter;
Nutzt die zahlreichen unabhängigen Pfade in quasi-zufälligen Graphen effizient aus.
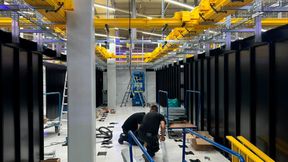
Bevor RNG produktiv gehen konnte, musste das Team beweisen, dass die Modelle auch in der Praxis halten. Zur Validierung der mathematischen Modelle für Pfadlängen, Routenzahl und Verkehrsverteilung nutzte das Team rund 530 Prozessorjahre Simulation auf Amazon „EC2“, umgerechnet der Betrieb eines einzelnen Prozessors über ein halbes Jahrtausend. Für den finalen Praxistest vor dem ersten Produktiveinsatz verkabelte das Team ein Rechenzentrum in Irland von Hand und ohne ShuffleBoxen, also genau in jenem Kabelgewirr, das die ShuffleBox eigentlich vermeiden soll. Das Ergebnis bestätigte die Modelle exakt.
Über den Autor: Giacomo Bernardi ist Senior Principal Engineer bei AWS.
Sein Fazit lautet: „Die Resultate aus dem produktiven Betrieb sind messbar. RNG kommt mit 69 Prozent weniger Routern aus als ein vergleichbares Fat-Tree-Netzwerk. Das senkt Hardwarekosten, Kühlaufwand und operativen Aufwand an jedem Standort direkt. Der Datendurchsatz steigt um bis zu 33 Prozent gegenüber der bisherigen Architektur. Beim Stromverbrauch der Netzwerkgeräte rechnet AWS mit einer Reduktion von rund 40 Prozent, was sich entsprechend auf die CO2-Bilanz an den jeweiligen Standorten auswirkt.
Bildquelle: AWS
Hier setzt AWS RNG bereits ein:
Das erste Produktivrechenzentrum auf Basis von RNG ging Ende 2024 in Irland ans Netz. 2025 folgte der Rollout in Spanien und Deutschland, seit April 2026 ist die Architektur Standard für den Großteil der neu gebauten AWS-Rechenzentren weltweit. Für Kunden bedeutet das eine robustere Infrastruktur hinter jedem API-Aufruf, jeder Datenbankabfrage und jedem Trainingslauf für Machine-Learning-Modelle, ohne dass eine einzige Zeile Code angepasst werden muss.